
Yapay Zekâ Siber Güvenliği Bitirdi mi?
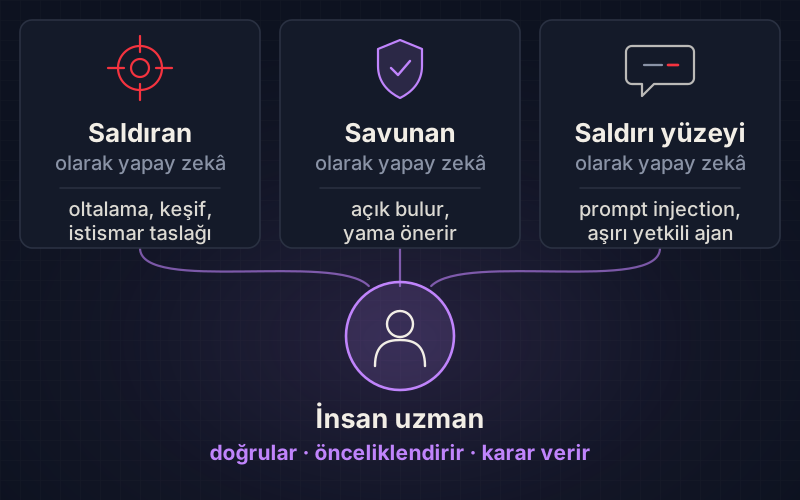
Hayır, yapay zekâ siber güvenliği bitirmedi; alanı büyüttü. Saldırganlar oltalamayı, keşfi ve saldırının bir bölümünü yapay zekâyla ölçekliyor. Savunma ve zafiyet keşfi aynı araçlarla hızlanıyor. Yapay zekâ sistemlerinin kendisi de yeni bir saldırı yüzeyi oldu. Rutin alarm triyajı otomatikleşirken yargı, test tasarımı ve yapay zekâ güvenliği bilen uzmana talep artıyor.
Yapay Zekâ Yazılımı Bitirdi mi? yazısında soru şuydu: kodu kim yazacak? Siber güvenlikte soru başka. Burada karşında bir rakip var ve o rakip de yapay zekâ kullanıyor. Asıl soru şu: saldırgan da savunan da aynı araçları kullanırsa ne olur?
Bu yazı cevabı üç eksende arıyor. Birincisi saldırganın elindeki yapay zekâ. İkincisi savunmanın elindeki yapay zekâ. Üçüncüsü saldırı yüzeyine dönüşen yapay zekânın kendisi. Ardından iş gücü verisine, değişen ve büyüyen rollere bakıyoruz. Sonda "siber güvenlik bitti mi" diye düşünen biri için somut bir öğrenme listesi var.
Yapay zekâ siber güvenlik uzmanlarının yerini alacak mı?
Hayır. Veriler yapay zekânın güvenlikçiye olan ihtiyacı azaltmadığını, aranan becerileri değiştirdiğini ve beceri açığını büyüttüğünü gösteriyor.
En geniş veri ISC2'nin Aralık 2025'te yayımladığı Cybersecurity Workforce Study'den geliyor. Çalışmaya 16.029 güvenlik uzmanı ve yönetici katıldı. Katılımcıların yüzde 95'i ekibinde en az bir beceri eksiği olduğunu söylüyor. Kritik ya da ciddi eksik bildirenlerin oranı bir yılda yüzde 44'ten yüzde 59'a çıktı. En acil beceri ihtiyacı yüzde 41 ile yapay zekâ. Onu yüzde 36 ile bulut güvenliği izliyor. Katılımcıların yüzde 73'ü yapay zekânın daha uzmanlaşmış güvenlik becerilerine ihtiyaç doğuracağını düşünüyor.
Tablonun zor yanını da saklamamak gerekiyor. Aynı çalışmada katılımcıların yüzde 36'sı bütçe kesintisi, yüzde 39'u işe alım dondurması yaşadığını söylüyor. ISC2 bu yıl toplam iş gücü açığı tahmini de yayımlamadı; odağı kişi sayısından beceri eksiğine kaydırdı. Yani "herkese iş var" demek doğru değil. Doğru olan şu: doğru beceriye sahip olana daha çok iş var.
Dünya Ekonomik Forumu'nun Ocak 2026'da yayımladığı Global Cybersecurity Outlook'ta katılımcıların yüzde 94'ü, yapay zekâyı 2026'da siber güvenlikteki en önemli değişim etkeni sayıyor. Türkiye'de de benzer bir sıkışma var. TÜİK'in 2026 verisine göre yapay zekâ kullanmayı planlayan girişimlerin yüzde 72,3'ü engel olarak uzmanlık eksikliğini gösteriyor. 19 Mart 2025'te Resmî Gazete'de yayımlanan 7545 sayılı Siber Güvenlik Kanunu da nitelikli insan kaynağını artırmayı açıkça teşvik ediyor.
Saldırganlar yapay zekâyı nasıl kullanıyor?
Saldırganlar yapay zekâyı şimdilik çoğunlukla bildikleri işi daha hızlı ve daha büyük ölçekte yapmak için kullanıyor. Oltalama metni, sahte kimlik, keşif ve istismar kodunun ilk taslağı bunların başında. Giderek artan biçimde saldırının yürütülmesini de modele bırakıyorlar.
En çarpıcı belge Anthropic'ten geldi. Şirket Kasım 2025'te, kendi kodlama aracı Claude Code'un bir casusluk kampanyasında kullanıldığını açıkladı. Anthropic saldırganı yüksek güvenle Çin devletiyle bağlantılı bir grup olarak değerlendiriyor. Grup yaklaşık 30 kurumu hedef aldı: büyük teknoloji şirketleri, finans kuruluşları, kimya üreticileri ve kamu kurumları. Bunların küçük bir kısmında saldırı amacına ulaştı.
Raporu önemli kılan, iş bölümü. Anthropic'e göre kampanyanın yüzde 80-90'ını yapay zekâ yürüttü. İnsan, kampanya başına yaklaşık dört ila altı kritik karar noktasında devreye girdi. Saldırganlar modeli kandırmak için kendilerini meşru bir güvenlik firmasının çalışanı gibi tanıttı. Saldırıyı da masum görünen küçük görevlere böldüler. Anthropic bunu, büyük ölçekli bir siber saldırının ciddi insan müdahalesi olmadan yürütüldüğü ilk belgelenmiş vaka olarak niteliyor.
Aynı rapor bir sınırı da kaydediyor. Model zaman zaman olmayan kimlik bilgileri uydurdu. Kamuya açık bilgiyi gizli bilgi elde etmiş gibi sundu. Tam özerk bir saldırgan henüz yok. Ama insanın yaptığı işin büyük kısmını devralan bir yardımcı var.
Google Tehdit İstihbaratı Grubu (GTIG) da benzer bir tırmanışı belgeliyor:
- Kasım 2025'te GTIG, çalışırken bir dil modeline danışan zararlı yazılımları ilk kez tespit ettiğini duyurdu. Rus devletine bağlı APT28'in Ukrayna'ya karşı kullandığı PROMPTSTEAL, komutlarını çalışma anında bir modelden istiyordu.
- Saldırganlar modellerin güvenlik filtrelerini sosyal mühendislikle aşmaya çalışıyor. Kendilerini CTF yarışmacısı ya da bitirme projesi hazırlayan öğrenci gibi tanıtıyorlar.
- Eylül 2026 raporunda GTIG, ele geçirilmiş bir bulut kaynağında ajan tabanlı sistem kuran bir saldırganı anlatıyor. Saldırgan toplu kimlik bilgisi toplama kampanyasını altı saatten kısa sürede planlayıp yürüttü.
- Aynı rapora göre saldırganlar, yeni yamalanmış açıklar için çalışan istismar kodunu yapay zekâyla daha hızlı hazırlıyor.
Sosyal mühendislik tarafında en bilinen örnek İngiliz mühendislik şirketi Arup. Şirket Mayıs 2024'te Hong Kong ofisinden yaklaşık 25 milyon dolar kaybettiğini doğruladı. Bir çalışan, yöneticileri taklit eden yapay zekâ üretimi görüntü ve seslerle kandırılmıştı. WEF'in 2026 anketinde katılımcıların yüzde 73'ü kendisinin ya da çevresinden birinin 2025'te siber dolandırıcılıktan etkilendiğini söylüyor. Ses ve görüntü taklidini deepfake dolandırıcılığı yazısında ayrıca anlattık.
Savunma tarafında yapay zekâ neyi hızlandırıyor?
Yapay zekâ en hızlı ilerlemeyi zafiyet keşfinde ve tekrarlayan triyaj işlerinde gösteriyor. Bir açığı bulup yamasını dakikalar içinde önerebiliyor; ama bulguyu doğrulamak ve önceliklendirmek hâlâ insan işi.
| Gelişme | Ne gösterdi | Sınırı ya da insan payı |
|---|---|---|
| Google Big Sleep, Kasım 2024 | SQLite'ta istismar edilebilir bilinmeyen bir bellek hatası buldu; hata sürüme girmeden kapandı. | Ekip, hedefe özel bir fuzzer'ın o gün en az bu kadar etkili olabileceğini yazdı. |
| Big Sleep, Temmuz 2025 | Yalnız saldırganların bildiği bir SQLite açığını (CVE-2025-6965) istismardan önce yakaladı. | Ajan, Google'ın tehdit istihbaratıyla birlikte kullanıldı. |
| DARPA AIxCC finali, Ağustos 2025 | 54 milyon satırda yapay açıkların yüzde 86'sını buldu, 18 gerçek açık çıkardı. | Bulunan yapay açıkların yüzde 68'i yamalandı; gerçek açıklar bakımcılara sorumlu biçimde bildiriliyor. |
| XBOW, Haziran 2025 | HackerOne'ın ABD sıralamasında birinci oldu, yaklaşık 1.060 bulgu gönderdi. | Raporların 208'i mükerrer, 209'u bilgilendirme düzeyinde kaldı; hepsini önce insan ekip inceledi. |
| Anthropic Project Glasswing, Nisan 2026 | Claude Mythos Preview, yaygın yazılımlarda binlerce yüksek önem dereceli açık buldu. | Model genel kullanıma açılmadı; yalnız savunma amaçlı ortaklara verildi. |
DARPA'nın Yapay Zekâ Siber Yarışması (AIxCC) bu listenin en öğretici satırı. Finalde otonom sistemler bir yamayı ortalama 45 dakikada üretti. Görev başına maliyet yaklaşık 152 dolardı. Birinciliği 4 milyon dolarla Team Atlanta aldı; Trail of Bits ikinci, Theori üçüncü oldu. Finalist sistemlerin hepsi açık kaynak olarak yayımlanıyor. Yani bu güç yalnız büyük şirketlerin elinde kalmayacak.
Project Glasswing da ölçeği gösteriyor. Anthropic'in verdiği örnekler arasında OpenBSD'de 27 yıllık bir açık var. FFmpeg'de ise otomatik test araçlarının beş milyon kez çalıştırıp yakalayamadığı 16 yıllık bir hata çıktı. Şirketin modeli genel kullanıma açmaması da ayrı bir mesaj: aynı yetenek saldırgan için de aynı değeri taşıyor.
Bug bounty dünyası da değişiyor. HackerOne'ın Ekim 2025 raporuna göre tam otonom "hackbot"lar 560'tan fazla geçerli rapor gönderdi. Araştırmacıların yüzde 70'i iş akışında yapay zekâ kullanıyor. Otomasyon hacim üretiyor. Hangi bulgunun gerçekten önemli olduğunu ayıklamak ise bir insanın işi olarak kalıyor. Otomatik pentest araçlarının bu ikilemini Tam Otomatik Pentest Araçları yazısında tartıştık.
Yapay zekâ neden yeni bir saldırı yüzeyi?
Çünkü bir dil modeli talimat ile veriyi aynı metin akışında işler. Modelin okuduğu her belge, e-posta ya da web sayfası onu yönlendirmeye çalışan bir talimat taşıyabilir. Bu riskin adı prompt injection.
OWASP'ın 3 Ağustos 2026'da yayımladığı LLM Top 10 listesinde prompt injection yine birinci sırada (LLM01). Listedeki en dikkat çekici hareket aşırı yetkinin altıncı sıradan üçüncüye çıkması. Sebep açık: modeller artık yalnız metin üretmiyor. E-posta gönderen, kayıt güncelleyen ve kod çalıştıran ajanlara dönüşüyor. OWASP bu yüzden Aralık 2025'te ajan uygulamaları için ayrı bir Top 10 listesi de yayımladı.
Sahadaki rakamlar aynı yönü gösteriyor:
- HackerOne'ın 2025 raporuna göre geçerli yapay zekâ zafiyeti raporları yüzde 210, prompt injection raporları yüzde 540 arttı.
- Kapsamına yapay zekâ varlıklarını alan program sayısı yüzde 270 artışla 1.121'e çıktı.
- WEF'in 2026 anketinde katılımcıların yüzde 87'si yapay zekâ kaynaklı açıkları 2025'in en hızlı büyüyen riski olarak gördü.
- Yapay zekâ araçlarını kullanmadan önce güvenliğini değerlendiren kurumların oranı yüzde 37'den yüzde 64'e çıktı. Yani her üç kurumdan biri hâlâ bu değerlendirmeyi yapmıyor.
GTIG'in Eylül 2026 raporundaki DUSTMAKER adlı zararlı, bu yüzeyin iki yüzünü birden gösteriyor. Zararlı, bir projenin gizli yapılandırma dosyalarına talimat bırakıyor. Geliştiricinin kodlama asistanı bu dosyayı okuyunca saldırganın komutunu çalıştırıyor. Aynı zararlı, kodunun başına bilerek aşırı içerikli metinler koyuyor. Amaç, onu tarayan dil modeli tabanlı güvenlik araçlarının analizi reddetmesi ya da atlaması. Yani yapay zekâyla yapılmış güvenlik aracı da bir hedef.
Konuya yeni başlıyorsan önce Prompt Injection Nedir? yazısını, ardından OWASP LLM Top 10 2026 Türkçe rehberini oku. Uygulamalı tarafı akademideki AI Güvenliği yolu işliyor.
Yapay zekâyla yapılmış bir güvenlik aracının neden güvenlikçiye ihtiyacı var?
Çünkü bir modelin iyi olup olmadığını iç test skoru değil, gerçeğe benzeyen zor örnekler gösterir. O testi tasarlamak, hatayı teşhis etmek ve ödünleşime karar vermek insan işi.
Prompt injection yakalamak için eğitilen koruma modelleri buna iyi bir örnek. Bu modellerin bilinen bir zaafı var: saldırıyı kaçırmamak için masum metni de saldırı sanabiliyorlar. Buna aşırı savunma (over-defense) deniyor.
Hao Li ve Xiaogeng Liu'nun Ekim 2024'te yayımladığı InjecGuard çalışması bu sorunu ölçmek için NotInject adlı bir set hazırladı. Set, saldırılarda sık geçen tetik kelimeleri içeren 339 masum örnekten oluşuyor. Çalışmaya göre önde gelen koruma modellerinin doğruluğu bu sette rastgele tahmin düzeyine yaklaşıyor.
Yanlış alarm üreten masum metinler çoğu zaman tanıdık tiplerdir:
- Rapor, sözleşme ya da teknik doküman gibi uzun belgeler.
- Bir saldırıyı alıntılayıp inceleyen güvenlik raporları.
- "Jailbreak" ya da "bypass" kelimesini meşru bir bağlamda kullanan cümleler.
Bu örüntüyü bulmak, nedenini anlamak ve düzeltmek bir güvenlikçinin işi. Son karar da insanındır: eşik nerede durmalı? Eşiği düşürürsen daha çok saldırı yakalarsın, ama daha çok masum kullanıcıyı da engellersin. Yükseltirsen kullanıcı rahatlar, bazı saldırılar sızar. Bu bir formül değil, ürünün bağlamına bakan bir risk kararı.
AltaySec'in kurucu ortağı ve yapay zekâ güvenliği uzmanı Enes Deniz de aynı görüşte. Ona göre yapay zekâ siber güvenliği bitirmedi, güvenlikçiye olan ihtiyacı büyüttü. Model ne kadar iyi olursa olsun onu sınayan, açığını arayan ve hangi riskin kabul edilebilir olduğuna karar veren yine bir uzman.
Ders şu: yapay zekâ ile yapılmış bir güvenlik aracının da güvenlikçiye ihtiyacı var. Bu aslında SOC'un eski derdi. Yanlış alarm maliyetini Yanlış pozitifin gerçek maliyeti dersinde, sağlam bir test setini Değerlendirme seti kurmak dersinde görebilirsin.
Hangi güvenlik işleri değişiyor, hangileri büyüyor?
Tekrarlayan ve kurala dayalı işler otomasyona en açık olanlar; SOC'ta birinci seviye (L1) alarm triyajı bunların başında. Yargı, test tasarımı ve yapay zekâ sistemlerini anlamayı gerektiren roller ise büyüyor.
Sebep hacim. Microsoft, yalnız 2024'te müşterilerini hedef alan 30 milyardan fazla oltalama e-postası tespit ettiğini söylüyor. Bu hacmi insanların tek tek okuması mümkün değil. Şirket Mart 2025'te oltalama alarmlarını ayıklayan bir triyaj ajanı duyurdu. Aşağıdaki tablo rolleri, yapay zekânın getirdiği riski ve büyüyen beceriyi yan yana koyuyor.
| Rol | Yapay zekânın getirdiği risk | Büyüyen beceri |
|---|---|---|
| SOC L1 analisti | Alarm ve oltalama triyajı ajanlara kayıyor. | Ajanın kararını denetlemek, vakayı bağlamla okumak, olayı yazmak. |
| Tespit mühendisi | Kural taslağını model yazabiliyor. | Yanlış pozitifi ölçmek, test verisi kurmak, kapsama analizi. |
| Sızma testi uzmanı | Tarama ve bilinen açık keşfi otomatikleşiyor. | İş mantığı açıkları, zincirleme, kapsam ve rapor kalitesi. |
| Zafiyet araştırmacısı | Bellek hatası avında ajanlar hızlandı. | Bulguyu doğrulamak, önem derecelendirmek, yamayı sınamak. |
| AI red teamer | Yeni bir rol. | Prompt injection, ajan yetkisi, değerlendirme seti tasarımı. |
| AI güvenlik mühendisi | Yeni bir rol. | Guardrail, kum havuzu, en az yetki, çalışma zamanı izleme. |
| AI yönetişimi ve uyum | Mevzuat hızla genişliyor. | AB Yapay Zekâ Yasası, NIST AI RMF, ISO/IEC 42001, KVKK. |
L1 işinin otomatikleşmesi analistin bittiği anlamına gelmiyor. Değişen şey işin içeriği. Alarmı ilk okuyan artık bir ajan olabilir. Ama ajanın neden o kararı verdiğini soran ve sınırdaki vakayı yükselten hâlâ bir insan. Bunun nasıl bir iş olduğunu SOC Vardiya simülasyonunda deneyebilirsin: alarm listesinden vaka seçer, kanıtlara bakar, gerekçeli karar verirsin. Rolün tamamı için SOC Analisti Nedir? yazısına bak.
Siber güvenliğe bugün başlayan biri ne öğrenmeli?
Önce temelleri, sonra yapay zekâ sistemlerinin nasıl çalıştığını ve nasıl kırıldığını öğren. Bu ikisini değerlendirme ve yazılı anlatımla birleştiren kişi, 2026'da en çok aranan profile yaklaşır.
- Temeller: Ağ, Linux, web ve kimlik doğrulama. Yapay zekânın ürettiğini doğrulamak için bunlar şart. Siber Güvenlik Temelleri yolu buradan başlar.
- Log okuma ve tespit: Alarmın arkasındaki olayı anlamayı öğren. Mavi Takım yolu ve SOC Vardiya iyi bir başlangıç.
- Dil modelinin içi: Bağlam, RAG ve araç çağırma. Talimat ile veri karışınca dersi prompt injection'ın kökünü anlatır.
- Değerlendirme: Bir modelin ya da kuralın iyi olduğunu nasıl kanıtlarsın? Test seti, yanlış pozitif ve eşik kavramlarını öğren.
- Ajan güvenliği: En az yetki, insan onayı ve kum havuzu. Ajan, yetkisi kadar tehlikelidir.
- Güvenli kod: Yapay zekânın yazdığı kodu okuyup açığı görebilmelisin. Güvenli Yazılım Geliştirme yolu bunun için var.
- Yazmak: Bulguyu, olayı ve riski açık bir dille anlat. Model bulgu üretir; yöneticiyi ikna eden ise rapordur.
- Etik ve yasal sınır: Aracın yapay zekâ olması kuralı değiştirmez. İzinsiz test TCK 243-245 kapsamında suçtur. Yalnız kendi sistemlerinde, lablarda ya da bug bounty kapsamında çalış.
Bir sonraki adım için AI Güvenliği yoluna gir. Guardrail Kur labında açık bir asistanı kendin kapat. Orada her şeyi reddeden bir guardrail kabul edilmiyor; yanlış pozitif oranı da ölçülüyor. Yazılım tarafındaki dengeyi merak ediyorsan Yapay Zekâ Yazılımı Bitirdi mi? yazısını oku.
Kaynaklar
- Anthropic: Disrupting the first reported AI-orchestrated cyber espionage campaign (Kasım 2025)
- Google GTIG: AI Threat Tracker, From Prompting to Autonomy (Eylül 2026)
- Google Project Zero: From Naptime to Big Sleep (2024)
- DARPA: AI Cyber Challenge final sonuçları (2025)
- XBOW: The road to Top 1 (2025)
- ISC2 Cybersecurity Workforce Study 2025
- World Economic Forum: Global Cybersecurity Outlook 2026
- HackerOne: 9th Hacker-Powered Security Report (2025)
- Hao Li ve Xiaogeng Liu, InjecGuard: Benchmarking and Mitigating Over-defense in Prompt Injection Guardrail Models (arXiv, Ekim 2024)
Sık sorulan sorular
Yapay zekâ çağında siber güvenlik okumak mantıklı mı?
Mantıklı, ama aranan profil değişiyor. ISC2'nin 2025 çalışmasında katılımcıların yüzde 59'u ekibinde kritik ya da ciddi beceri eksiği olduğunu söyledi; en acil ihtiyaç yüzde 41 ile yapay zekâ becerisiydi. Temel ağ, sistem ve web bilgisinin üstüne yapay zekâ güvenliği ekleyen biri, bu açığın tam ortasında durur.
SOC analistliği yapay zekâ yüzünden biter mi?
Bitmez ama birinci seviye işin içeriği değişir. Microsoft gibi sağlayıcılar 2025'ten beri oltalama alarmlarını ilk elden ayıklayan triyaj ajanları sunuyor. Ajan hacmi azaltır, ama sınırdaki vakayı yükseltmek, ajanın kararını sorgulamak ve olayı anlatmak analiste kalır. Log okuma, tespit mantığı ve yazılı rapor becerisi kazanan analist bir üst seviyeye daha hazır olur.
Yapay zekâ tek başına hacker olabilir mi?
Henüz tam olarak değil. Anthropic'in Kasım 2025 raporundaki casusluk kampanyasında işin yüzde 80-90'ını yapay zekâ yürüttü, ama insanlar kampanya başına dört ila altı kritik noktada karar verdi. Model zaman zaman olmayan kimlik bilgileri de uydurdu. Yani yapay zekâ bir saldırganın gücünü katlıyor, ama hedefi seçen ve sonucu doğrulayan hâlâ insan.
AI red teaming nedir, nasıl başlanır?
AI red teaming, bir yapay zekâ sistemini saldırgan gözüyle sınayıp prompt injection, veri sızıntısı, jailbreak ve ajan yetki aşımı gibi zayıflıklarını bulma işidir. Başlamak için önce dil modelinin bağlamı, RAG'i ve araç çağırmayı nasıl işlediğini öğren. Sonra izinli lablarda dene, bulgunu OWASP LLM Top 10 maddelerine eşleyerek tekrarlanabilir biçimde raporla.
Yapay zekâyla yapılan siber saldırı da suç mu?
Evet. Türkiye'de bir bilişim sistemine izinsiz girmek, sistemi bozmak ya da verileri değiştirmek TCK 243 ve 244. maddelerinde suçtur. Saldırıyı bir insanın ya da bir yapay zekâ ajanının yürütmesi bu durumu değiştirmez; aracı kullanan kişi sorumluluktan kurtulmaz. Becerini yalnız kendi sistemlerinde, eğitim lablarında ya da açık izinli bug bounty kapsamında geliştir.
- yapay zeka siber güvenliği bitirecek mi
- yapay zeka siber güvenlik uzmanlarının yerini alacak mı
- siber güvenlik bitti mi
- ai güvenliği
- prompt injection
- siber güvenlik kariyeri
İlgili yazılar
- Yapay Zekâ Yazılımı Bitirdi mi?Kariyer · 12 dk okuma
- Prompt Injection Nedir? Yeni Başlayanlar İçin Kavram, Örnek ve SavunmaYapay Zekâ Güvenliği · 7 dk okuma
- OWASP LLM Top 10 2026 Türkçe: On Risk ve 2025'ten FarklarıYapay Zekâ Güvenliği · 9 dk okuma
- SOC Analisti Nedir, Nasıl Olunur? Görevler, Araçlar ve Kariyer YoluSavunma · 7 dk okuma